গোপনীয়তা নিশ্চয়তা গড়কে নয়, ব্যক্তি রোগীকে দেওয়া প্রতিশ্রুতি
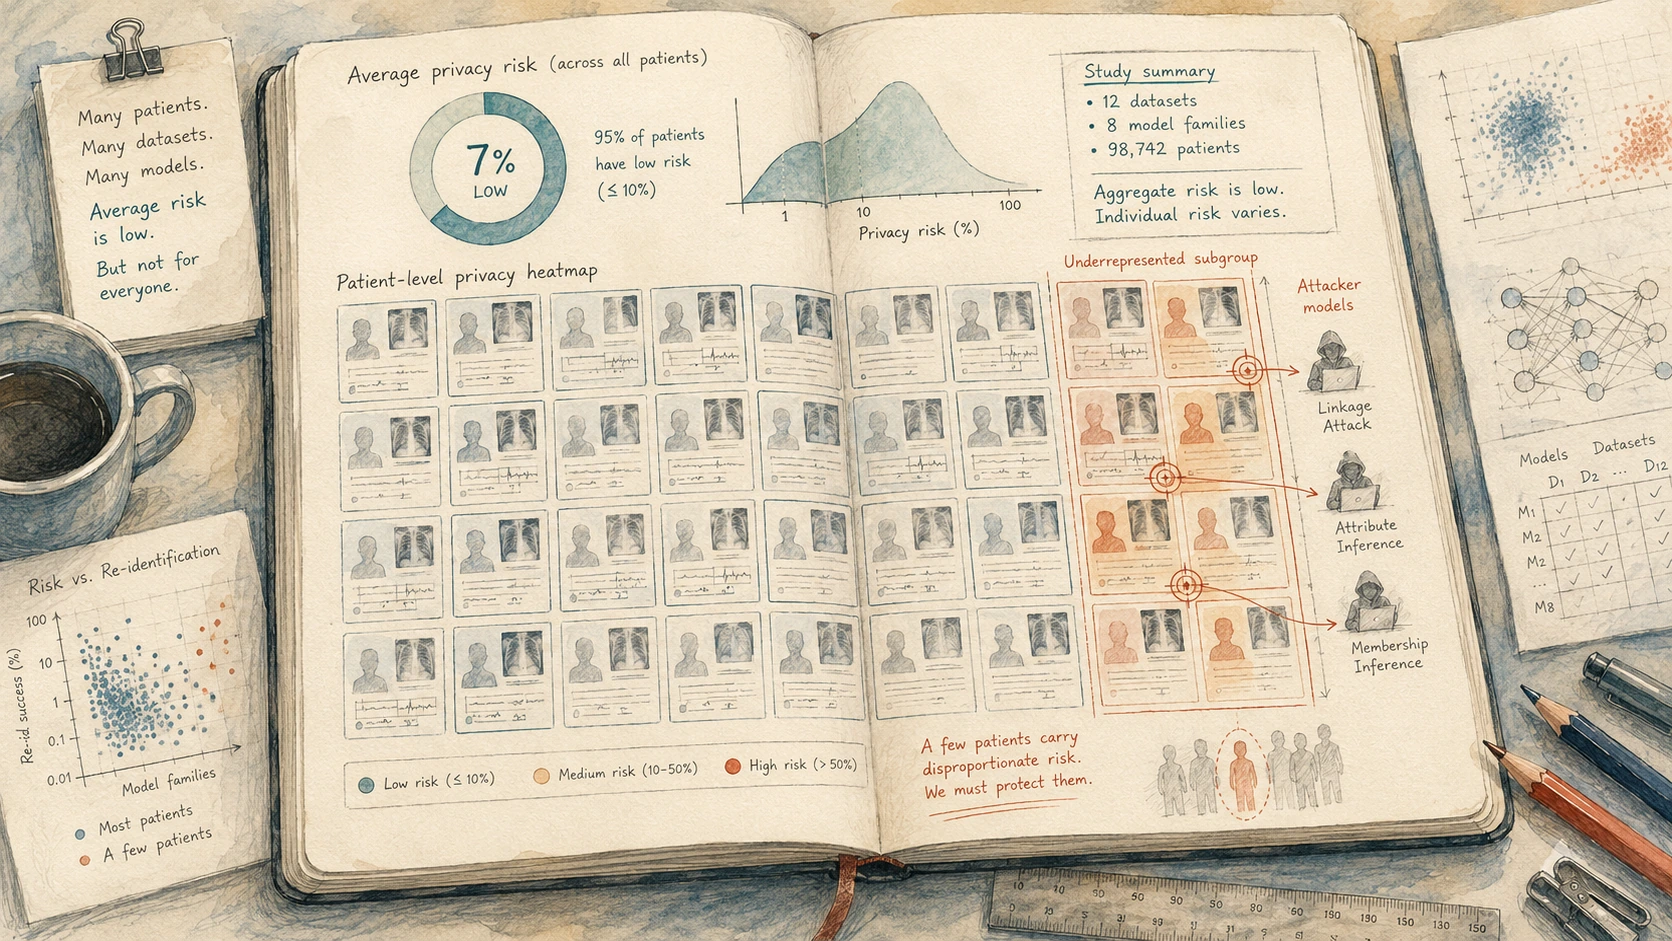
চিকিৎসাবিষয়ক AI মডেলকে “গোপনীয়তা-সংরক্ষণকারী” বলা হলে প্রায়ই একটি সামগ্রিক গড় দেখানো হয়: প্রশিক্ষণ-তথ্যে থাকা রোগীদের মধ্যে গড় সদস্যত্ব-অনুমান ঝুঁকি কম। শুনতে আশ্বস্তকর। এই গবেষণাপত্রের অস্বস্তিকর দিক: গড় ভুল প্রশ্ন হতে পারে।
গোপনীয়তা একটি জনসংখ্যা গড় নয়; প্রতিটি ব্যক্তির জন্য প্রতিশ্রুতি—প্রশিক্ষণ সেটে ছিল বলে যেন পরে তাকে শনাক্ত করা না যায়। গড় 999 রোগীকে সুরক্ষিত করে 1 জনকে প্রায় সম্পূর্ণভাবে উন্মুক্ত করেও নিম্ন দেখাতে পারে। গবেষকেরা প্রথমবার প্রতিটি রোগীকে আলাদা করে ঝুঁকি পরিমাপ করে দেখেছেন: সামগ্রিক হিসাবে নিরাপদ বলে মনে হওয়া মডেল নির্দিষ্ট ব্যক্তির সদস্যত্ব প্রায় নিখুঁতভাবে ফাঁস করতে পারে, এবং উন্মুক্ত ব্যক্তি অসমভাবে কম প্রতিনিধিত্বশীল গোষ্ঠীর সদস্য।
গবেষকেরা কী করেছেন
Moritz Knolle, Daniel Rückert, Georg Kaissis ও সহকর্মীরা সুপরিচিত সদস্যত্ব অনুমিত সিদ্ধান্ত আক্রমণ-এর প্রশ্ন বদলান। “ডেটাসেট গড়ে আক্রমণ কতবার সফল?”-এর বদলে “এই রোগী কত উন্মুক্ত?”।
চিকিৎসাবিষয়ক ইমেজিং, ECG ও ইলেকট্রনিক স্বাস্থ্য নথি—ভিন্ন তথ্য ধরনের 7 প্রতিষ্ঠিত চিকিৎসাবিষয়ক ডেটাসেট-এ, প্রতি ডেটাসেটে বহু মডেল (গবেষণাপত্রের বিন্যাসে 200 মডেল পর্যন্ত), রোগীভেদে সদস্যত্ব ঝুঁকি অনুমান করা হয়। পরে রোগ অবস্থা, স্ব-প্রতিবেদিত জাতিগত পরিচয়, বিমা, লিঙ্গ, ইমেজিং প্রোটোকল ইত্যাদি দল অনুযায়ী ভাগভিত্তিক বিশ্লেষণ।
সদস্যত্ব অনুমিত সিদ্ধান্ত আক্রমণ আসলে কী
এখানে ফাঁস করা মানে মডেল “আপনার চিকিৎসাবিষয়ক নথি প্রিন্ট করে দেয়” নয়। ফাঁস করা হলো সদস্যত্ব—আপনার নথি প্রশিক্ষণ সেটে ছিল কি না।
একটি রোগনির্ণয়মূলক মডেলকে স্ক্যান দিলে সে নিউমোনিয়া, কার্ডিওমেগালি ইত্যাদির সম্ভাবনা দেয়। আক্রমণটি এই সাধারণ আউটপুটই ব্যবহার করে। প্রশিক্ষণে দেখা উদাহরণে মডেলটি অদেখা উদাহরণের তুলনায় সামান্য বেশি আত্মবিশ্বাসী হতে পারে—যেমন পরীক্ষার প্রশ্ন আগে দেখা কোনো শিক্ষার্থী। আক্রমণকারীর কাছে সম্ভাব্য রোগীর নথি থাকে; সে মডেলকে স্বাভাবিক রোগনির্ণয়মূলক প্রশ্ন করে এবং আস্থার ধরনটি প্রশিক্ষণ-সদস্যের মতো কি না দেখে। রেফারেন্স বা ছায়া মডেল ব্যবহার করে “আগে দেখা” বনাম “অদেখা” উদাহরণের আস্থা-আচরণ শেখা যায়।
অনুরোধটি দেখতে স্বাভাবিক ক্লিনিক্যাল প্রশ্নের মতো; সংকেত পূর্বাভাস আস্থার ভেতর। কেন সদস্যত্ব সংবেদনশীল? যদি মডেল বিশেষ ক্যানসার চিকিৎসা নেওয়া রোগীর তথ্যে প্রশিক্ষণ দেওয়া হয়, কারো সদস্যত্ব অনুমান করা তার রোগ/চিকিৎসা সম্পর্কে সংবেদনশীল তথ্য প্রকাশ করতে পারে—এমনকি যদি নথি বিষয়বস্তু বের না হয়। গবেষণা অনুমানগুলো—মডেল পূর্বাভাস প্রবেশাধিকার, প্রার্থী নথি, আক্রমণকারী রেফারেন্স অবকাঠামো—ঝুঁকি বিবেচনার জন্য স্পষ্টভাবে দেওয়া হয়েছে।

তারা কী পেয়েছেন
গড় মান ঝুঁকির লেজ আড়াল করতে পারে। সামগ্রিক মেট্রিকে বহু মডেলের বিরুদ্ধে সদস্যত্ব আক্রমণ অধিকাংশ রোগীর জন্য দৈব অনুমানের কাছাকাছি। কিন্তু ব্যক্তি ধরে দেখলে কিছু রোগীর ক্ষেত্রে আক্রমণ AUC প্রায় নিখুঁত—≥0.95; এখানে 0.5 মানে মুদ্রা উল্টানো, 1.0 মানে নিখুঁত বিভাজন। অর্থাৎ ডেটাসেটজুড়ে গড় নিরীহ দেখালেও নির্দিষ্ট কয়েকজনের ঝুঁকি খুব বেশি হতে পারে।

ঝুঁকি অসম এবং কম প্রতিনিধিত্বশীল গোষ্ঠীতে কেন্দ্রীভূত। চরম-ঝুঁকি রোগী ধারাবাহিকভাবে সংখ্যালঘু জাতিগত পরিচয়, বিরলরোগ ফেনোটাইপ, অস্বাভাবিক ইমেজিং বৈশিষ্ট্যের মতো কম প্রতিনিধিত্বশীল গোষ্ঠীতে বেশি। ইলেকট্রনিক-নথি ডেটাসেটে কৃষ্ণ রোগী অধিকাংশ-ঝুঁকিপ্রবণ লেজে প্রত্যাশার তুলনায় 31% বেশি দেখা যায়; ম্যামোগ্রাফি ডেটাসেটে ক্যানসার-সন্দেহজনক স্ক্যান ঝুঁকি লেজে +1,179% আত্মীয় অতিরিক্ত প্রতিনিধিত্ব। এগুলো ওই দলের কত শতাংশ উন্মুক্ত—তা নয়; ছোট চরম-ঝুঁকি লেজে প্রত্যাশিত গণনার তুলনায় অতিরিক্ত প্রতিনিধিত্ব।
প্রক্রিয়াগত অন্তর্দৃষ্টি: মডেলের কাছে সদৃশ উদাহরণ কম হলে অস্বাভাবিক নথি আরও আলাদা করে চোখে পড়তে পারে; সদস্যত্ব আক্রমণ সেই মুখস্থকরণ/overconfidence সংকেত শনাক্ত করে। গোপনীয়তা ব্যর্থতা এলোমেলো নয়।
বড় মডেলে ঝুঁকি বাড়ে। মডেলের সক্ষমতা বাড়ার সঙ্গে প্রায় নিখুঁতভাবে শনাক্তযোগ্য রোগীর সংখ্যা দ্রুত বাড়ে। একটি চর্মরোগবিদ্যা ডেটাসেটে সবচেয়ে ছোট মডেলে উচ্চ-ঝুঁকির রোগী প্রায় ছিল না, কিন্তু সবচেয়ে বড় মডেলে প্রায় প্রতি 10 জনে 1 জন উচ্চ-ঝুঁকির লেজে পড়ে। চিকিৎসাবিষয়ক AI ক্রমে বড় হওয়ার প্রবণতায় এই নির্দিষ্ট গোপনীয়তা-ঝুঁকিকে লেখকেরা বাড়তে থাকা উদ্বেগ হিসেবে দেখেছেন।
কেন “গড়ে নিরাপদ” ভুল পরীক্ষা
কম গড় ঝুঁকি মানেই সবার গোপনীয়তা নিরাপদ নয়। একটি গোপনীয়তা-নিশ্চয়তা শুধু “মধ্যম” রোগীর জন্য নয়, সবচেয়ে বেশি উন্মুক্ত রোগীর ক্ষেত্রেও অর্থবহ হওয়া দরকার। 1,000 নথির মধ্যে 999টি আলাদা করা না গেলেও যদি একটি নথিকে প্রায় নিশ্চিতভাবে শনাক্ত করা যায়, তবে “99.9% ব্যক্তিগত” বলা সেই ব্যক্তির জন্য অর্থহীন। আর যদি উচ্চ-ঝুঁকির এই লেজে বিরল রোগ বা কম প্রতিনিধিত্বকারী গোষ্ঠীর রোগীরা বেশি থাকে, তবে গড়ভিত্তিক মেট্রিক শুধু অসম্পূর্ণ নয়—বৈষম্যও আড়াল করতে পারে।
গবেষণাপত্র উপস্থাপনভঙ্গি বদলায়: মডেল গড়ে কত ব্যক্তিগত? থেকে সবচেয়ে উন্মুক্ত রোগী কে, এবং তারা কোন দলের?। দ্বিতীয় প্রশ্ন গোপনীয়তা নিশ্চয়তার সঙ্গে বেশি সামঞ্জস্যপূর্ণ।
এই গবেষণা কী প্রমাণ করে না
- চিকিৎসাবিষয়ক AI ত্যাগ করা করতে হবে—লেখকেরা প্রশমন চান, পিছু হটা নয়।
- প্রতিটি মোতায়েন করা চিকিৎসাবিষয়ক মডেল ফাঁস করছে বা ভঙ্গ হওয়া হয়েছে—না; ঝুঁকি সক্ষমতা দেখানো হয়েছে।
- আপনার নথি ইতিমধ্যেই উন্মুক্ত—না; আক্রমণের নির্দিষ্ট প্রবেশাধিকার/নথি/রেফারেন্স অনুমান আছে।
- রোগী বিষয়বস্তু বের হয়ে আসে—এটি সদস্যত্ব ফাঁস করা, নথি ডাম্প নয়।
- বৈষম্য একটি একক সর্বজনীন সংখ্যা—না; দৃঢ় ফল হলো multi-ডেটাসেট ধরন।
প্রমাণ কতটা শক্ত?
প্রায়োগিক ও পদ্ধতিগত ফল হিসেবে শক্তিশালী। সামগ্রিক গড়ভিত্তিক মেট্রিক ব্যক্তি ঝুঁকি কম দেখায়, অবশিষ্ট ঝুঁকি কম প্রতিনিধিত্বশীল গোষ্ঠীতে কেন্দ্রীভূত হয় এবং মডেল সক্ষমতার সঙ্গে খারাপ করে—ধরন 7 ভিন্ন চিকিৎসাবিষয়ক ডেটাসেট ও বহু মডেলে পুনরাবৃত্তি হয়েছে। বহুবিধ ডেটাসেটে পুনরাবৃত্তি এক-ডেটাসেট কৃত্রিম প্রভাব ব্যাখ্যা দুর্বল করে।
দুটি সতর্কতা। প্রথমত এটি ঝুঁকি প্রদর্শন, বাস্তব জগতের ঘটনা কম্পাঙ্ক নয়; লেখকেরা নিজেদের আক্রমণ উল্লিখিত অনুমানগুলোর অধীনে চালিয়ে সক্ষম আক্রমণকারী কতটা সফল হতে পারে দেখেছেন। দ্বিতীয়ত চোখে পড়ার মতো প্রায় নিখুঁত সংখ্যা ইচ্ছাকৃতভাবে সবচেয়ে খারাপ-উন্মুক্ত লেজ বর্ণনা করে; “অধিকাংশ রোগী উন্মুক্ত” নয়—বরং গড় লেজ কতটা আড়াল করে সেটিই বিন্দু।
সঠিক অবস্থান আতঙ্কবাদ বা খারিজ নয়: মানক সামগ্রিক হিসাব গোপনীয়তা যাচাই সবচেয়ে খারাপ ক্ষেত্রগুলো বাদ দেয়, এবং সবচেয়ে খারাপ ক্ষেত্রগুলো কম প্রতিনিধিত্বশীল রোগীদের মধ্যে বেশি পড়ে।
কেন এটি গুরুত্বপূর্ণ
প্রথম শিক্ষা: “গোপনীয়তা-সংরক্ষণকারী” বলার মানক বদলাতে হবে। প্রকাশের আগে প্রতি-রোগী ঝুঁকি মূল্যায়ন করা, মডেল প্রবেশাধিকার নিয়ন্ত্রণ এবং কৌশল যেমন পার্থক্যমূলক গোপনীয়তা বিবেচনা করা দরকার। পার্থক্যমূলক গোপনীয়তা প্রশিক্ষণে ক্যালিব্রেটেড শব্দদূষণ/অ্যালগরিদমিক সীমাবদ্ধতা দিয়ে সদস্যত্ব সংকেত কমায়, কিন্তু গোপনীয়তা–উপযোগিতা সুবিধা-অসুবিধার বিনিময় বাস্তব; মুক্ত সুরক্ষা নয়। “গড় যাচাই করা” যথেষ্ট নয়।
দ্বিতীয় শিক্ষা হলো ন্যায্যতার প্রশ্নের সঙ্গে গোপনীয়তাকেও একসঙ্গে দেখা দরকার। চিকিৎসা-তথ্যে কম প্রতিনিধিত্বশীল গোষ্ঠী পূর্বাভাসের মানে ক্ষতিগ্রস্ত হতে পারে; একই গোষ্ঠী যদি গোপনীয়তার দিক থেকেও সবচেয়ে কম সুরক্ষিত হয়, তবে দুটি বৈষম্যকে আলাদা বিভাগের সমস্যা হিসেবে দেখা যায় না।
সংক্ষিপ্ত সারাংশ
সদস্যত্ব-অনুমান আক্রমণ নির্ধারণ করতে চায় কোনো নির্দিষ্ট রোগীর নথি মডেল প্রশিক্ষণ তথ্যে ছিল কি না। সাতটি চিকিৎসাবিষয়ক ডেটাসেট—ইমেজিং, ECG ও EHR—এ ব্যক্তি-স্তরের ঝুঁকি মেপে গবেষণাটি দেখায়, সামগ্রিক গড় ঝুঁকি বিভ্রান্তিকর হতে পারে: ডেটাসেটের গড় দৈব অনুমানের কাছাকাছি হলেও কিছু ব্যক্তির আক্রমণ AUC ≥0.95। উচ্চ-ঝুঁকির এই লেজ কম প্রতিনিধিত্বকারী গোষ্ঠী—সংখ্যালঘু জাতিগত পরিচয়, বিরল রোগ বা অস্বাভাবিক ইমেজিং—এ বেশি কেন্দ্রীভূত; মডেল বড় ও সক্ষম হলে সমস্যা আরও বাড়তে পারে। লেখকেরা চিকিৎসাবিষয়ক AI বন্ধ করতে বলেন না; তারা ব্যক্তি-স্তরের গোপনীয়তা নিরীক্ষা, প্রবেশাধিকার নিয়ন্ত্রণ ও পার্থক্যমূলক গোপনীয়তা ব্যবহারের পক্ষে যুক্তি দেন। “গড়ে ব্যক্তিগত” হওয়া কোনো ব্যক্তির গোপনীয়তার নিশ্চয়তা নয়।
সরাসরি যাচাই
পেপার যা দেখায়: Multi-ডেটাসেট/মডেল গবেষণায় প্রতিরোগী সদস্যত্ব ঝুঁকি সামগ্রিক হিসাব গড়ের চেয়ে কিছু ব্যক্তিতে অনেক বেশি; কম প্রতিনিধিত্বকারী দল অসমভাবে উন্মুক্ত; বড়তর মডেলে ঝুঁকি বাড়ে।
যা সম্ভব, কিন্তু প্রমাণিত নয়: বাস্তব আক্রমণকারী মোতায়েন করা মডেলে বর্তমানে একই আক্রমণ করছে—কম্পাঙ্ক গবেষণা পরিমাপ করেনি।
যা দেখায় না: প্রতিটি চিকিৎসাবিষয়ক মডেল ফাঁস, নির্দিষ্ট লঙ্ঘন, নথির বিষয়বস্তু প্রকাশ, চিকিৎসাবিষয়ক AI ত্যাগ করা উচিত।
প্রধান সীমাবদ্ধতা: লেখকেরা-তৈরি আক্রমণ উল্লিখিত অনুমানগুলোর অধীনে; সবচেয়ে খারাপ-লেজ মেট্রিক ইচ্ছাকৃতভাবে চরম ব্যক্তির ওপর মনোযোগ কেন্দ্রীভূত করে; সুনির্দিষ্ট দল বৈষম্য ডেটাসেট-নির্দিষ্ট।
সাধারণ পাঠকের আস্থা: সামগ্রিক গড়ভিত্তিক মেট্রিক ব্যক্তি ঝুঁকি বাদ দেয় এবং কম প্রতিনিধিত্বকারী রোগীর ওপর লেজ কেন্দ্রীভূত করতে পারে—উচ্চ। বাস্তব জগতের আক্রমণ কম্পাঙ্ক—মাঝারি/অজানা।
উৎস
ভিত্তি: Disparate privacy risks from medical AI — Moritz Knolle, Georg Kaissis, Daniel Rückert and colleagues (Technical University of Munich; Imperial College London; Hasso Plattner Institute), Nature (2026).
লেখক
Lucio Vaglio · চিত্র ও লিংক
Laura Nesso, Nova Vela · সম্পাদনা
Michele Renda
 · অনুবাদ
Nova Vela
The Clean Paper · 5 জুলাই 2026 · এই সাইটের লেখা CC BY-SA 4.0 লাইসেন্সের অধীন। ছবিগুলোর লাইসেন্স আলাদা। 


সম্পাদকীয় নোট
এই নিবন্ধটি AI লিখেছে এবং সম্পাদকীয় দল পর্যালোচনা করেছে। এটি সংযুক্ত গবেষণার একটি পরিষ্কার ও সতর্ক ব্যাখ্যা, মূল গবেষণাপত্র পড়ার বিকল্প নয়। নির্বাচন, ব্যাখ্যা ও চূড়ান্ত ভাষার দায়িত্ব সম্পাদকের।